1. 특징
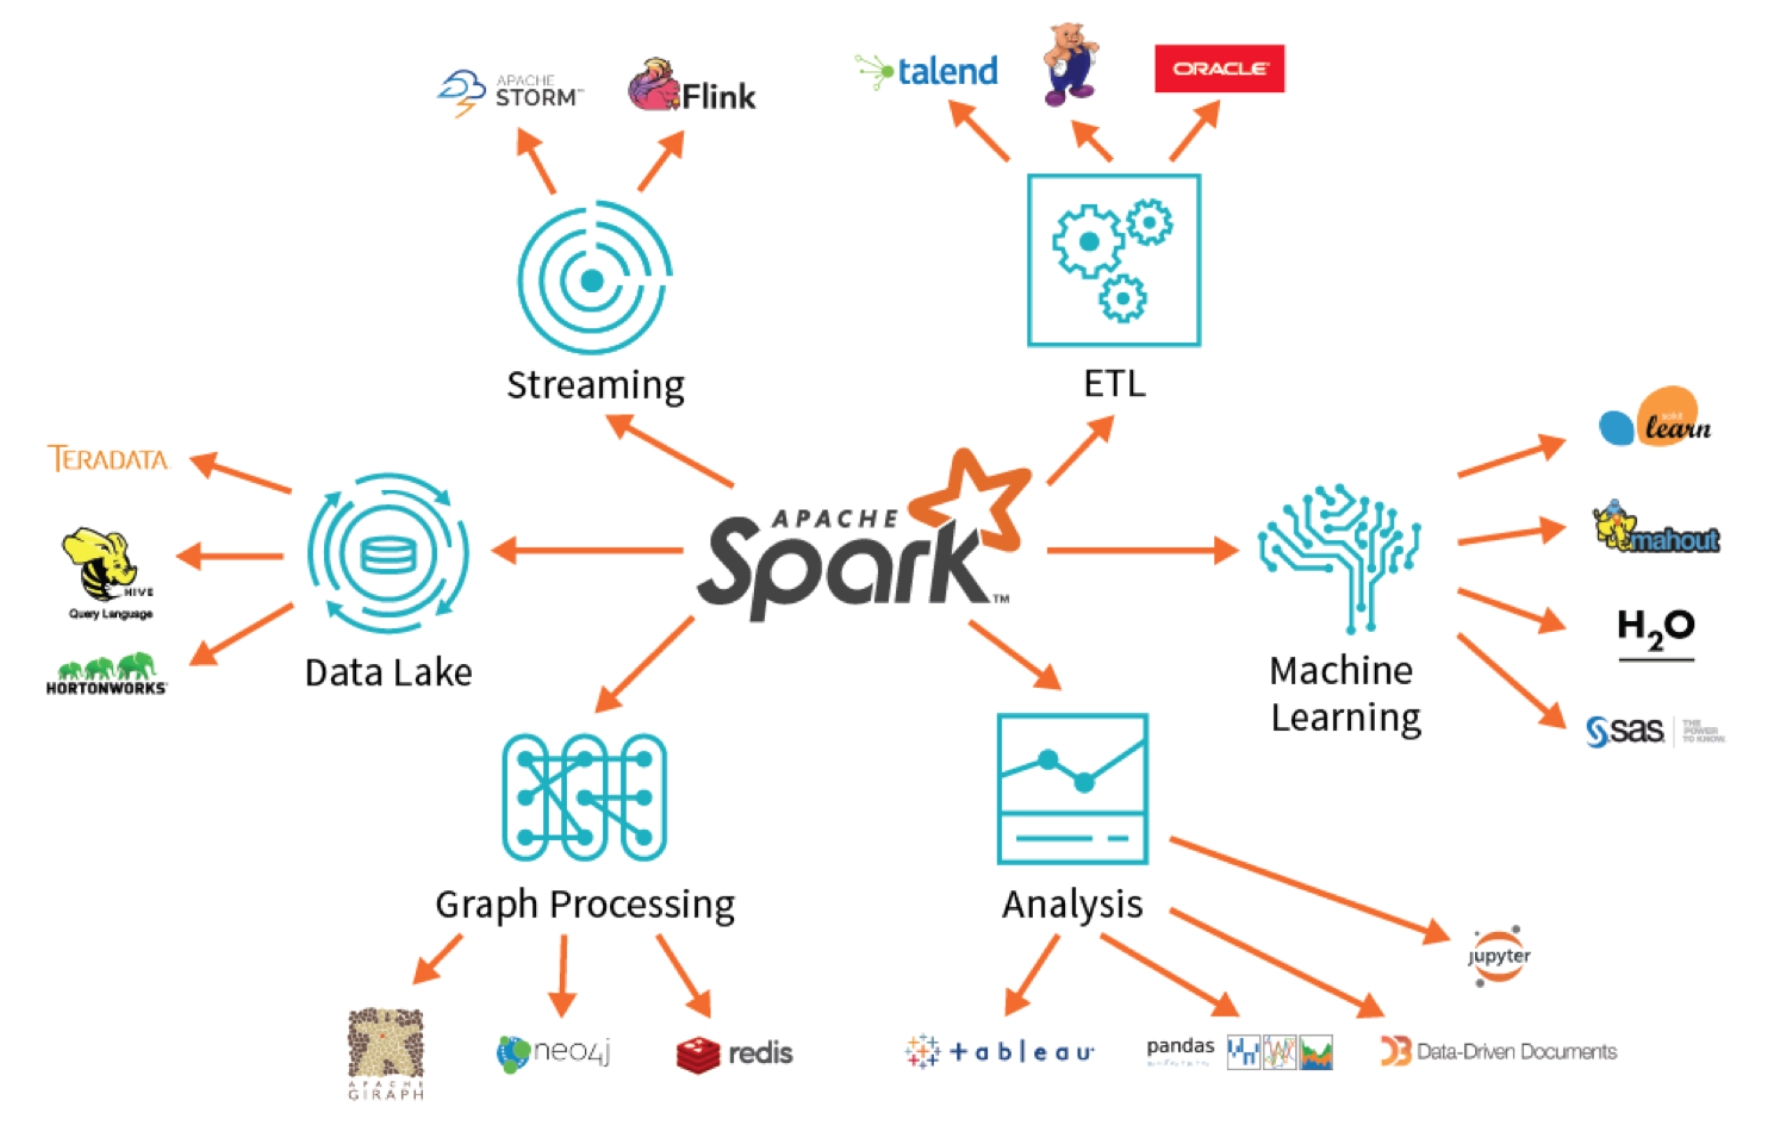
1) Apache Spark 는 데이터 처리를 위한 범용 프레임워크이다. 데이터 파이프라인을 위해 많이 사용되며, 산업 표준에 가깝다. Spark는 MapReduce와 유사한 일괄처리 기능, 실시간 데이터 처리기능, SQL과 유사한 정형 데이터 처리 기능, 그래프 알고리즘, 머신러닝 알고리즘을 모두 단일 프레임워크로 통합 했다.
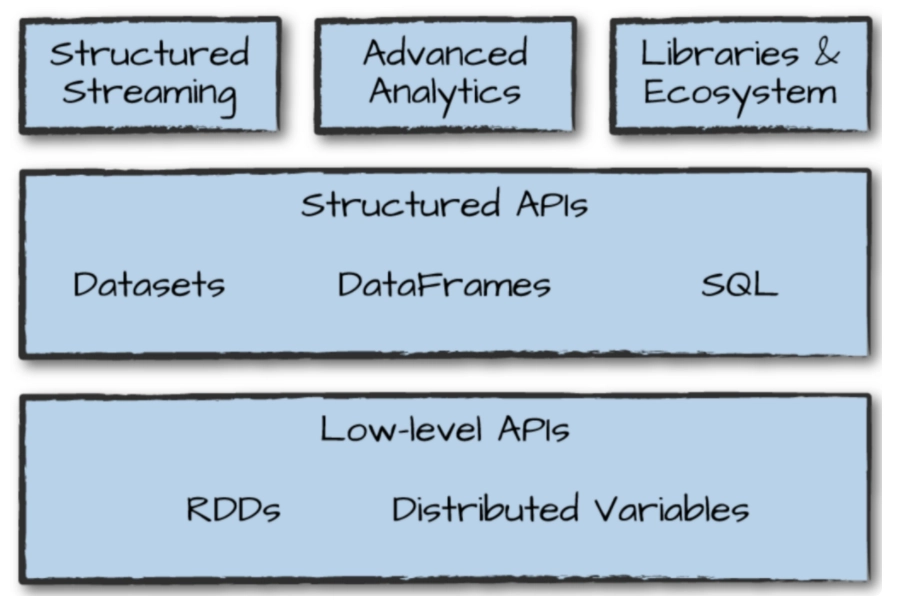
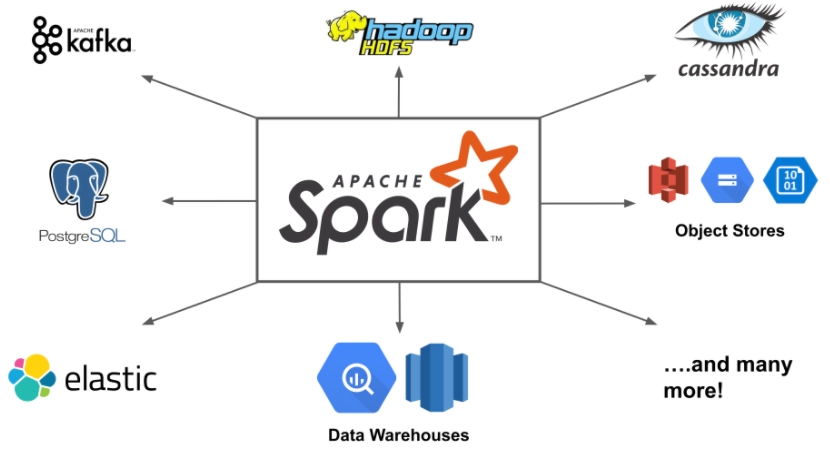
Spark의 저장소·API·작업 영역 Spark의 저장소·API·작업 영역 저장소 · connector · kafka · HDFS · cassandra · PostgreSQL · Object Stores · elastic · Data Warehouses · …and many more · Apache Spark · Structured · Streaming · Advanced · Analytics · Libraries · & Ecosystem · Structured APIs · Datasets · Scala · Java · DataFrames · Python · Scala · Java · R · SQL · 모든 언어(spark.sql) · Low-level APIs · RDDs · Distributed Variables · 작업 영역 · Streaming · ETL · Machine Learning · Analysis · Graph Processing · Data Lake. 결과를 다시 저장소에 씁니다. 한 프레임워크 안에서 처리합니다. 저장소 · connector kafka HDFS cassandra PostgreSQL Object Stores elastic Data Warehouses …and many more Apache Spark Structured Streaming Advanced Analytics Libraries & Ecosystem Structured APIs Datasets Scala · Java DataFrames Python · Scala · Java · R SQL 모든 언어(spark.sql) Low-level APIs RDDs · Distributed Variables 작업 영역 Streaming ETL Machine Learning Analysis Graph Processing Data Lake Spark의 저장소·API·작업 영역 저장소 · connector · kafka · HDFS · cassandra · PostgreSQL · Object Stores · elastic · Data Warehouses · …and many more · Apache Spark · Structured · Streaming · Advanced · Analytics · Libraries · & Ecosystem · Structured APIs · Datasets · Scala · Java · DataFrames · Python · Scala · Java · R · SQL · 모든 언어(spark.sql) · Low-level APIs · RDDs · Distributed Variables · 작업 영역 · Streaming · ETL · Machine Learning · Analysis · Graph Processing · Data Lake. 결과를 다시 저장소에 씁니다. 한 프레임워크 안에서 처리합니다. 저장소 · connector kafka HDFS cassandra PostgreSQL Object Stores elastic Data Warehouses …and many more Apache Spark Structured Streaming Advanced Analytics Libraries & Ecosystem Structured APIs Datasets Scala · Java DataFrames Python · Scala · Java · R SQL 모든 언어(spark.sql) Low-level APIs RDDs · Distributed Variables 작업 영역 Streaming ETL Machine Learning Analysis Graph Processing Data Lake 완료 장면 설명. 같은 API로 처리한 결과를 저장소에 씁니다. 실행: Standalone · YARN · Kubernetes.
과정 보기 1. connector로 여러 저장소의 데이터를 읽습니다.
Spark의 저장소·API·작업 영역 · 1 저장소 · connector · kafka · HDFS · cassandra · PostgreSQL · Object Stores · elastic · Data Warehouses · …and many more · Apache Spark · Structured · Streaming · Advanced · Analytics · Libraries · & Ecosystem · Structured APIs · Datasets · DataFrames · SQL · Low-level APIs · RDDs · Distributed Variables · 작업 영역 · Streaming · ETL · Machine Learning · Analysis · Graph Processing · Data Lake. 읽은 데이터는 Low-level API(RDD·분산 변수) 위에서 다룹니다. 저장소 · connector kafka HDFS cassandra PostgreSQL Object Stores elastic Data Warehouses …and many more Apache Spark Structured Streaming Advanced Analytics Libraries & Ecosystem Structured APIs Datasets DataFrames SQL Low-level APIs RDDs · Distributed Variables 작업 영역 Streaming ETL Machine Learning Analysis Graph Processing Data Lake Spark의 저장소·API·작업 영역 · 1 저장소 · connector · kafka · HDFS · cassandra · PostgreSQL · Object Stores · elastic · Data Warehouses · …and many more · Apache Spark · Structured · Streaming · Advanced · Analytics · Libraries · & Ecosystem · Structured APIs · Datasets · DataFrames · SQL · Low-level APIs · RDDs · Distributed Variables · 작업 영역 · Streaming · ETL · Machine Learning · Analysis · Graph Processing · Data Lake. 읽은 데이터는 Low-level API(RDD·분산 변수) 위에서 다룹니다. 저장소 · connector kafka HDFS cassandra PostgreSQL Object Stores elastic Data Warehouses …and many more Apache Spark Structured Streaming Advanced Analytics Libraries & Ecosystem Structured APIs Datasets DataFrames SQL Low-level APIs RDDs · Distributed Variables 작업 영역 Streaming ETL Machine Learning Analysis Graph Processing Data Lake 2. Low-level API(RDD·분산 변수) 위에 Structured API(Dataset·DataFrame·SQL)가 있습니다.
Spark의 저장소·API·작업 영역 · 2 저장소 · connector · kafka · HDFS · cassandra · PostgreSQL · Object Stores · elastic · Data Warehouses · …and many more · Apache Spark · Structured · Streaming · Advanced · Analytics · Libraries · & Ecosystem · Structured APIs · Datasets · Scala · Java · DataFrames · Python · Scala · Java · R · SQL · 모든 언어(spark.sql) · Low-level APIs · RDDs · Distributed Variables · 작업 영역 · Streaming · ETL · Machine Learning · Analysis · Graph Processing · Data Lake. 스트리밍·분석·라이브러리가 같은 API 위에서 동작합니다. 저장소 · connector kafka HDFS cassandra PostgreSQL Object Stores elastic Data Warehouses …and many more Apache Spark Structured Streaming Advanced Analytics Libraries & Ecosystem Structured APIs Datasets Scala · Java DataFrames Python · Scala · Java · R SQL 모든 언어(spark.sql) Low-level APIs RDDs · Distributed Variables 작업 영역 Streaming ETL Machine Learning Analysis Graph Processing Data Lake Spark의 저장소·API·작업 영역 · 2 저장소 · connector · kafka · HDFS · cassandra · PostgreSQL · Object Stores · elastic · Data Warehouses · …and many more · Apache Spark · Structured · Streaming · Advanced · Analytics · Libraries · & Ecosystem · Structured APIs · Datasets · Scala · Java · DataFrames · Python · Scala · Java · R · SQL · 모든 언어(spark.sql) · Low-level APIs · RDDs · Distributed Variables · 작업 영역 · Streaming · ETL · Machine Learning · Analysis · Graph Processing · Data Lake. 스트리밍·분석·라이브러리가 같은 API 위에서 동작합니다. 저장소 · connector kafka HDFS cassandra PostgreSQL Object Stores elastic Data Warehouses …and many more Apache Spark Structured Streaming Advanced Analytics Libraries & Ecosystem Structured APIs Datasets Scala · Java DataFrames Python · Scala · Java · R SQL 모든 언어(spark.sql) Low-level APIs RDDs · Distributed Variables 작업 영역 Streaming ETL Machine Learning Analysis Graph Processing Data Lake 3. 같은 API로 처리한 결과를 저장소에 씁니다. 실행: Standalone · YARN · Kubernetes.
Spark의 저장소·API·작업 영역 · 3 저장소 · connector · kafka · HDFS · cassandra · PostgreSQL · Object Stores · elastic · Data Warehouses · …and many more · Apache Spark · Structured · Streaming · Advanced · Analytics · Libraries · & Ecosystem · Structured APIs · Datasets · Scala · Java · DataFrames · Python · Scala · Java · R · SQL · 모든 언어(spark.sql) · Low-level APIs · RDDs · Distributed Variables · 작업 영역 · Streaming · ETL · Machine Learning · Analysis · Graph Processing · Data Lake. 결과를 다시 저장소에 씁니다. 한 프레임워크 안에서 처리합니다. 저장소 · connector kafka HDFS cassandra PostgreSQL Object Stores elastic Data Warehouses …and many more Apache Spark Structured Streaming Advanced Analytics Libraries & Ecosystem Structured APIs Datasets Scala · Java DataFrames Python · Scala · Java · R SQL 모든 언어(spark.sql) Low-level APIs RDDs · Distributed Variables 작업 영역 Streaming ETL Machine Learning Analysis Graph Processing Data Lake Spark의 저장소·API·작업 영역 · 3 저장소 · connector · kafka · HDFS · cassandra · PostgreSQL · Object Stores · elastic · Data Warehouses · …and many more · Apache Spark · Structured · Streaming · Advanced · Analytics · Libraries · & Ecosystem · Structured APIs · Datasets · Scala · Java · DataFrames · Python · Scala · Java · R · SQL · 모든 언어(spark.sql) · Low-level APIs · RDDs · Distributed Variables · 작업 영역 · Streaming · ETL · Machine Learning · Analysis · Graph Processing · Data Lake. 결과를 다시 저장소에 씁니다. 한 프레임워크 안에서 처리합니다. 저장소 · connector kafka HDFS cassandra PostgreSQL Object Stores elastic Data Warehouses …and many more Apache Spark Structured Streaming Advanced Analytics Libraries & Ecosystem Structured APIs Datasets Scala · Java DataFrames Python · Scala · Java · R SQL 모든 언어(spark.sql) Low-level APIs RDDs · Distributed Variables 작업 영역 Streaming ETL Machine Learning Analysis Graph Processing Data Lake 원본 도해 2) Yarn, Mesos, k8s 등 환경을 위한 Cluster Manager가 있으며, SQL, Python, Scala 등을 위한 터미널, Jupyter 등 다양한 실행 모드 및 환경을 지원한다.
2. Why not RDBMS?
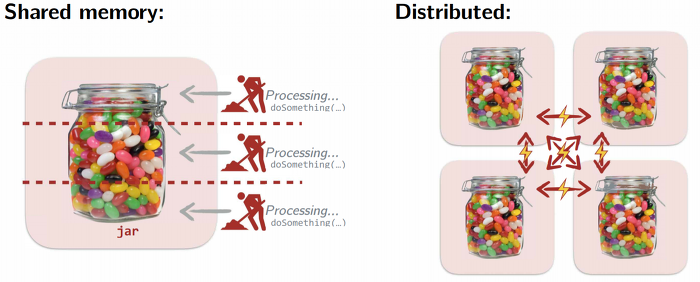
IT 환경이 고도화되어 처리할 데이터가 수백억건으로 증가함에 따라, 기존의 단일 소프트웨어로는 의미있는 정보를 검색/시각화/예측/분석 등을 하기에 어려움이 있다. DB 쿼리 성능의 주요 제약사항 중 하나는 쿼리의 순차적인 실행 이다. 대부분의 DB는 다수의 프로세서를 사용할 수 있지만, 하나의 쿼리를 위해 다수의 프로세서를 사용하지는 않는다. 다수의 쿼리를 한번에 수행하기 위해 (batch 등)병렬성을 활용하기는 한다. 하나의 쿼리를 병렬로 실행한다고 해도 DB 성능은 디스크 I/O속도에 의해 여전히 제한될 수 있다. 그리고 기존의 RDBMS를 Distributed Architecutre로 구성할 경우, ACID를 위해 복잡한 locking 방식과 복제 방식을 사용할 수 밖에 없다.
이에 OLAP(Online Analytical Processing), 텍스트 처리, 스트림 처리, 고차원 데이터 처리 등에 있어 특화된 아키텍처로 여러 방법론이 소개되었다. 다만, 데이터를 여러 노드에 나눠 처리한 후 결합하는 경우에도(Distributed Data Parallelism), 네트워크상의 오버헤드가 발생할 수 있다. 따라서 단일 머신에서도 처리할 수 있는 데이터셋을 다룰 때는 비효율적일 수 있으며, 대량의 원자성 트랜잭션을 빠르게 처리해야 하는 OLTP 작업에는 적합하지 않다.
3. Why not MapReduce?
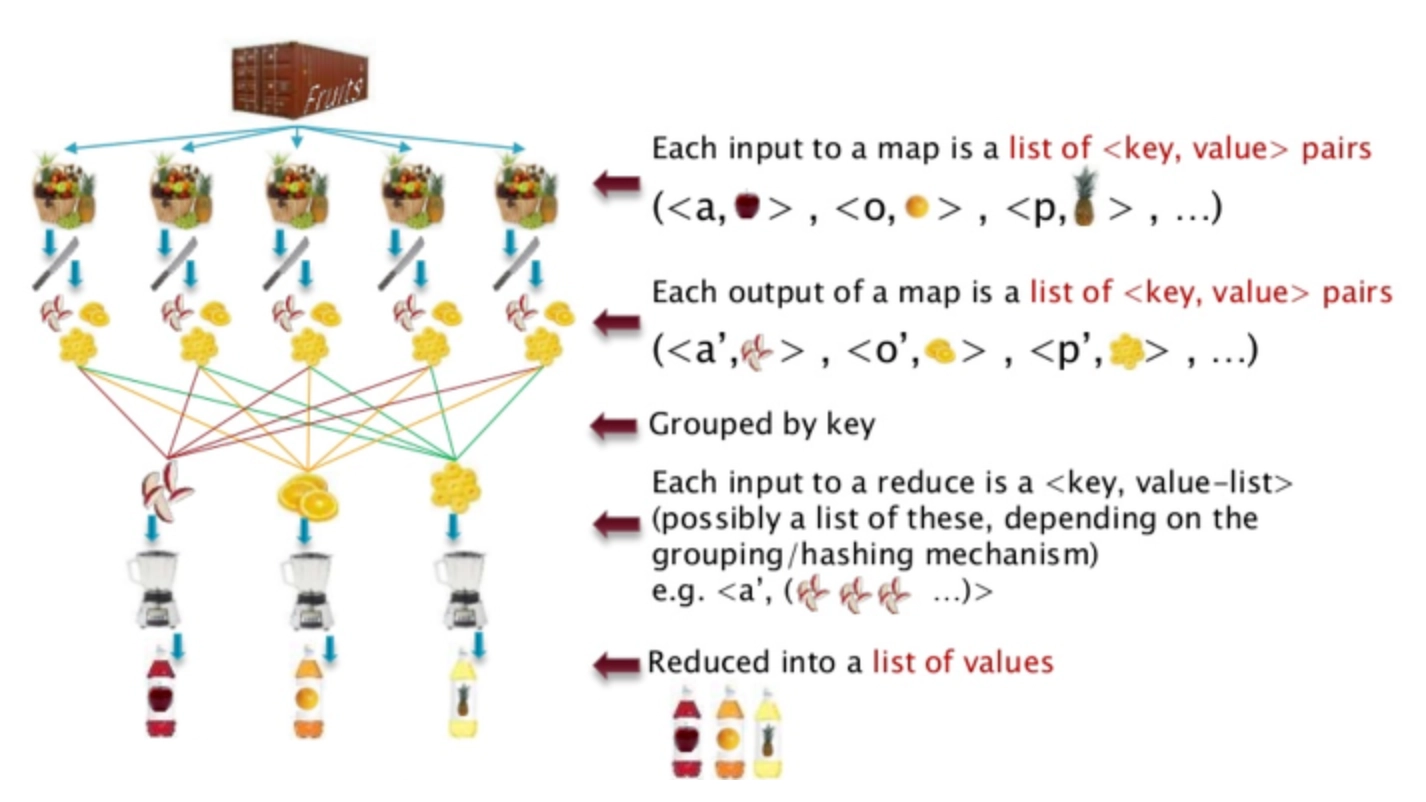
과거 구글은 MapReduce를 통해 빅데이터 관련 이슈를 해결하였다. MapReduce란, 문제를 쉽게 병렬화할 수 있게 나눈 후, 장비 클러스터 전체에서 이들을 조정하는 계산 패러다임이다. Hadoop은 분석을 병렬로 수행할 수 있도록 나눠주며, HDFS는 많은 디스크에 흩어져 있는 데이터를 병렬로 읽는다.
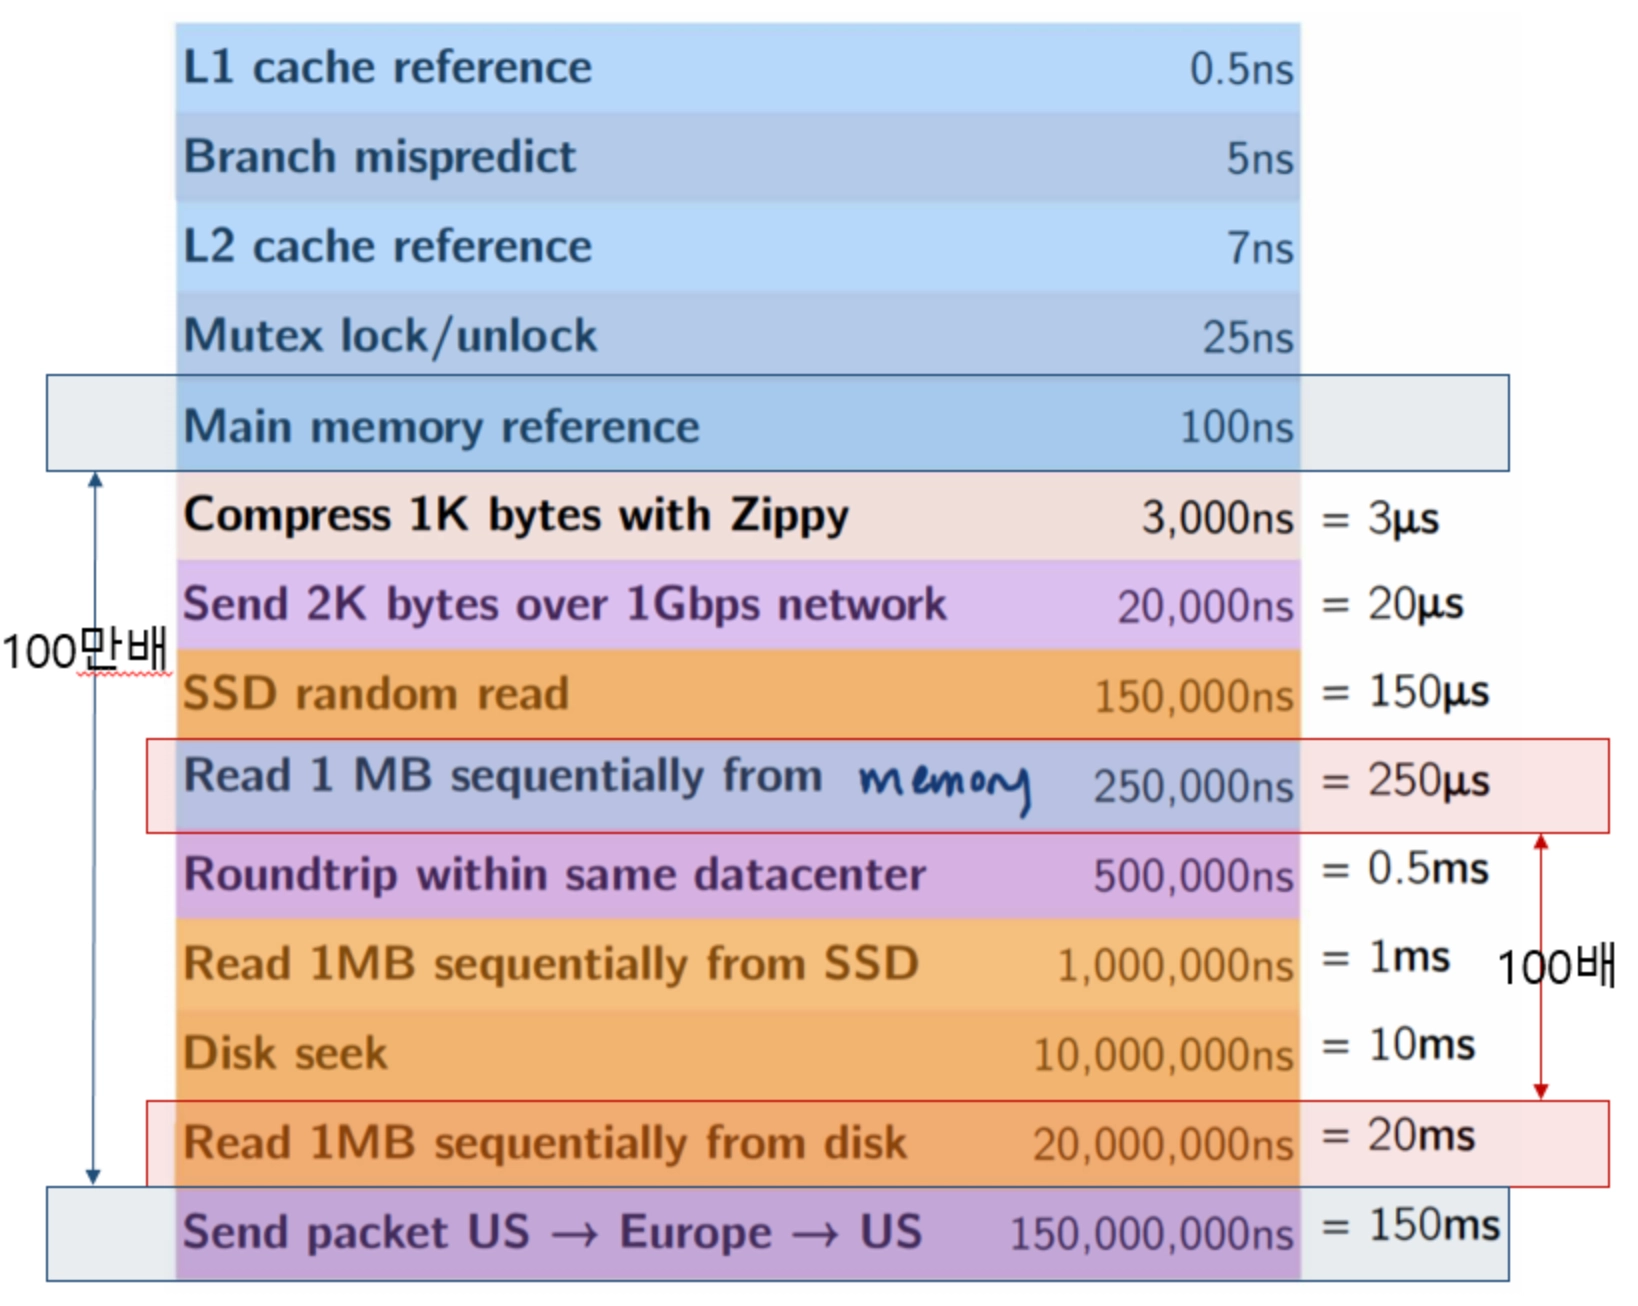
MapReduce 잡의 결과를 다른 잡에서 사용하려면 HDFS에 저장해야 한다. 메모리는 디스크에 비해 100배 빠르며 네트워크 통신에 비해 일반적으로 100만배 빠르다.
반복 처리와 cache 반복 처리와 cache MapReduce · HDFS · Job 1 · map → reduce · HDFS · Job 2 · map → reduce · HDFS · Job 3 · map → reduce · 디스크 읽기·쓰기 6회 · Spark · cache · 원본 · cache() 표시 · executor 메모리 · Partition 1 · Partition 2 · 반복 1 · 반복 2 · 반복 3 · P2 재계산 완료 · 원본 읽기 1회 + P2 재계산 1회 · 메모리 재사용 2회. 두 줄의 결과는 같습니다. 디스크를 거친 횟수가 다릅니다. MapReduce HDFS Job 1 map → reduce HDFS Job 2 map → reduce HDFS Job 3 map → reduce 디스크 읽기·쓰기 6회 Spark · cache 원본 cache() 표시 executor 메모리 Partition 1 Partition 2 반복 1 반복 2 반복 3 P2 재계산 완료 원본 읽기 1회 + P2 재계산 1회 · 메모리 재사용 2회 반복 처리와 cache MapReduce · HDFS · Job 1 · map → reduce · HDFS · Job 2 · map → reduce · HDFS · Job 3 · map → reduce · 디스크 읽기·쓰기 6회 · Spark · cache · 원본 · cache() 표시 · executor 메모리 · Partition 1 · Partition 2 · 반복 1 · 반복 2 · 반복 3 · P2 재계산 완료 · 원본 읽기 1회 + P2 재계산 1회 · 메모리 재사용 2회. 두 줄의 결과는 같습니다. 디스크를 거친 횟수가 다릅니다. MapReduce HDFS Job 1 map → reduce HDFS Job 2 map → reduce HDFS Job 3 map → reduce 디스크 읽기·쓰기 6회 Spark · cache 원본 cache() 표시 executor 메모리 Partition 1 Partition 2 반복 1 반복 2 반복 3 P2 재계산 완료 원본 읽기 1회 + P2 재계산 1회 · 메모리 재사용 2회 완료 장면 설명. 잃은 partition은 lineage로 그 부분만 다시 계산합니다. 결과는 같습니다.
과정 보기 1. MapReduce는 잡의 결과를 HDFS에 쓰고 다음 잡이 다시 읽습니다. Spark는 첫 action에서 partition을 메모리에 둡니다.
반복 처리와 cache · 1 MapReduce · HDFS · Job 1 · map → reduce · HDFS · Job 2 · map → reduce · 읽기 · Job 3 · map → reduce · 디스크 읽기·쓰기 2회 · Spark · cache · 원본 · cache() 표시 · executor 메모리 · Partition 1 · Partition 2 · 반복 1 · 반복 2 · 반복 3 · 원본 읽기 1회 · 메모리 재사용 0회. MapReduce는 잡마다 HDFS에 쓰고 다시 읽습니다. Spark는 메모리의 partition을 재사용합니다. MapReduce HDFS Job 1 map → reduce HDFS Job 2 map → reduce 읽기 Job 3 map → reduce 디스크 읽기·쓰기 2회 Spark · cache 원본 cache() 표시 executor 메모리 Partition 1 Partition 2 반복 1 반복 2 반복 3 원본 읽기 1회 · 메모리 재사용 0회 반복 처리와 cache · 1 MapReduce · HDFS · Job 1 · map → reduce · HDFS · Job 2 · map → reduce · 읽기 · Job 3 · map → reduce · 디스크 읽기·쓰기 2회 · Spark · cache · 원본 · cache() 표시 · executor 메모리 · Partition 1 · Partition 2 · 반복 1 · 반복 2 · 반복 3 · 원본 읽기 1회 · 메모리 재사용 0회. MapReduce는 잡마다 HDFS에 쓰고 다시 읽습니다. Spark는 메모리의 partition을 재사용합니다. MapReduce HDFS Job 1 map → reduce HDFS Job 2 map → reduce 읽기 Job 3 map → reduce 디스크 읽기·쓰기 2회 Spark · cache 원본 cache() 표시 executor 메모리 Partition 1 Partition 2 반복 1 반복 2 반복 3 원본 읽기 1회 · 메모리 재사용 0회 2. 반복할 때 Spark는 메모리의 partition을 재사용합니다.
반복 처리와 cache · 2 MapReduce · HDFS · Job 1 · map → reduce · HDFS · Job 2 · map → reduce · HDFS · Job 3 · map → reduce · 디스크 읽기·쓰기 5회 · Spark · cache · 원본 · cache() 표시 · executor 메모리 · Partition 1 · Partition 2 · 반복 1 · 반복 2 · 반복 3 · 원본 읽기 1회 · 메모리 재사용 2회. MapReduce는 잡마다 HDFS에 쓰고 다시 읽습니다. Spark는 메모리의 partition을 재사용합니다. MapReduce HDFS Job 1 map → reduce HDFS Job 2 map → reduce HDFS Job 3 map → reduce 디스크 읽기·쓰기 5회 Spark · cache 원본 cache() 표시 executor 메모리 Partition 1 Partition 2 반복 1 반복 2 반복 3 원본 읽기 1회 · 메모리 재사용 2회 반복 처리와 cache · 2 MapReduce · HDFS · Job 1 · map → reduce · HDFS · Job 2 · map → reduce · HDFS · Job 3 · map → reduce · 디스크 읽기·쓰기 5회 · Spark · cache · 원본 · cache() 표시 · executor 메모리 · Partition 1 · Partition 2 · 반복 1 · 반복 2 · 반복 3 · 원본 읽기 1회 · 메모리 재사용 2회. MapReduce는 잡마다 HDFS에 쓰고 다시 읽습니다. Spark는 메모리의 partition을 재사용합니다. MapReduce HDFS Job 1 map → reduce HDFS Job 2 map → reduce HDFS Job 3 map → reduce 디스크 읽기·쓰기 5회 Spark · cache 원본 cache() 표시 executor 메모리 Partition 1 Partition 2 반복 1 반복 2 반복 3 원본 읽기 1회 · 메모리 재사용 2회 3. 잃은 partition은 lineage로 그 부분만 다시 계산합니다. 결과는 같습니다.
반복 처리와 cache · 3 MapReduce · HDFS · Job 1 · map → reduce · HDFS · Job 2 · map → reduce · HDFS · Job 3 · map → reduce · 디스크 읽기·쓰기 6회 · Spark · cache · 원본 · cache() 표시 · executor 메모리 · Partition 1 · Partition 2 · 반복 1 · 반복 2 · 반복 3 · P2 재계산 완료 · 원본 읽기 1회 + P2 재계산 1회 · 메모리 재사용 2회. 두 줄의 결과는 같습니다. 디스크를 거친 횟수가 다릅니다. MapReduce HDFS Job 1 map → reduce HDFS Job 2 map → reduce HDFS Job 3 map → reduce 디스크 읽기·쓰기 6회 Spark · cache 원본 cache() 표시 executor 메모리 Partition 1 Partition 2 반복 1 반복 2 반복 3 P2 재계산 완료 원본 읽기 1회 + P2 재계산 1회 · 메모리 재사용 2회 반복 처리와 cache · 3 MapReduce · HDFS · Job 1 · map → reduce · HDFS · Job 2 · map → reduce · HDFS · Job 3 · map → reduce · 디스크 읽기·쓰기 6회 · Spark · cache · 원본 · cache() 표시 · executor 메모리 · Partition 1 · Partition 2 · 반복 1 · 반복 2 · 반복 3 · P2 재계산 완료 · 원본 읽기 1회 + P2 재계산 1회 · 메모리 재사용 2회. 두 줄의 결과는 같습니다. 디스크를 거친 횟수가 다릅니다. MapReduce HDFS Job 1 map → reduce HDFS Job 2 map → reduce HDFS Job 3 map → reduce 디스크 읽기·쓰기 6회 Spark · cache 원본 cache() 표시 executor 메모리 Partition 1 Partition 2 반복 1 반복 2 반복 3 P2 재계산 완료 원본 읽기 1회 + P2 재계산 1회 · 메모리 재사용 2회 4. What's Spark's advantages?
Hadoop이 HDFS + MapReduce 처리 엔진으로 구성된데 반해, Spark는 대량의 데이터를 메모리에 유지하는 독창적인 설계로 계산 성능을 대폭 끌어올렸다. 따라서 Spark는 Hadoop MapReduce보다 10~100배 빠른 속도로 같은 작업을 수행한다.
Spark는 여러 데이터 소스에서 읽을 경우 persist(), cache()
또한 Lazy execution Action Transformation
val largeList: List [String] = .. . val wordsRdd = sc. paralleize (largeList) val lengthsRdd = wordsRdd. map (_.length) -> lazy하기 때문에 아직 아무 작업도 안함 val totalChars = lengthsRdd. reduce () -> 이때 실행이 됨.